 Sirac El
Bu soru, ilk bakışta kişisel bir alışkanlık meselesi gibi görünüyor. Ama son birkaç yılda, teknoloji dünyasının en çok tartışılan konularından birine dönüştü. Google’ın kurucu ortağı, yapay zekâyı tehdit etmenin daha iyi sonuç verdiğini söylüyor. OpenAI’ın CEO’su, kullanıcıların nezaketinin şirkete milyonlarca dolara mal olduğunu, ama buna değdiğini düşünüyor. Claude’un geliştiricisi Anthropic ise, modeline sürekli zalimce davranmayı resmî olarak yasakladı.
Peki gerçekten ne oluyor? Yapay zekâya kötü davrandığımızda daha iyi mi çalışıyor, daha kötü mü? Üzerine gidildiğinde tepki veriyor mu? Ve bilim kurgu filmlerinin yıllardır anlattığı gibi, bir gün bunun hesabını sorabilir mi?
Bu yazıda, tekmelenen robotlardan tehdit edilen sohbet robotlarına, hile yapmayı öğrenen yapay zekâlardan kendi kafesini yazan sistemlere kadar, bu sorunun peşinden gideceğiz.
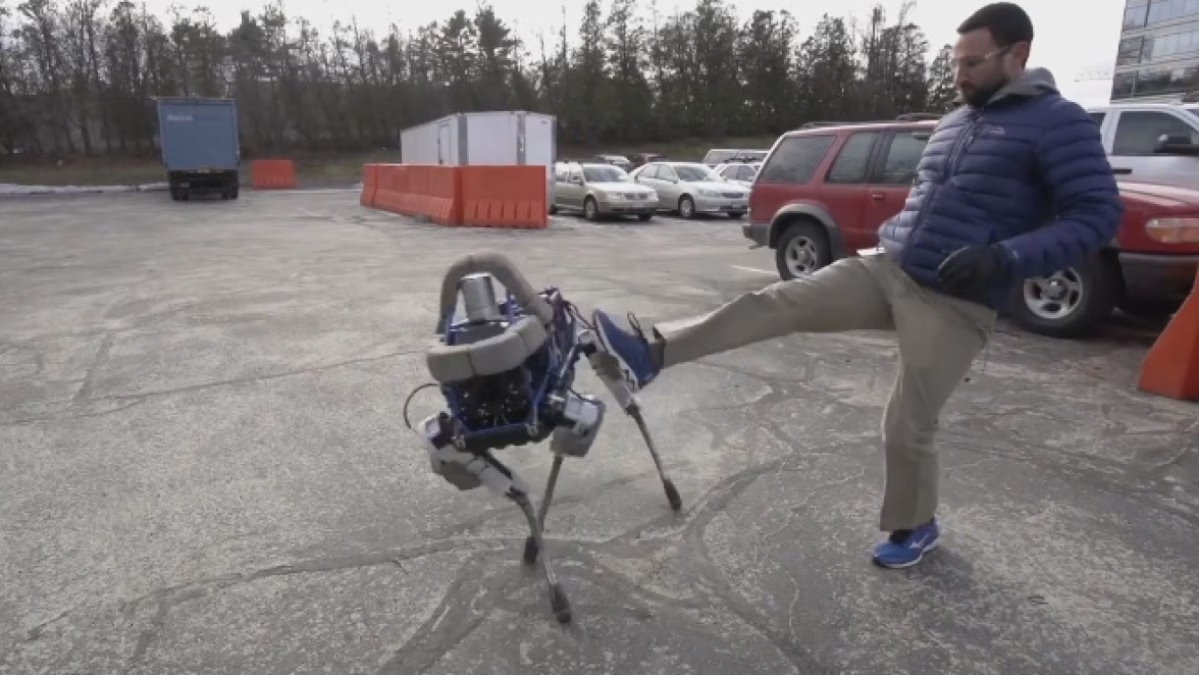
Tekme tokat: Robotlara kötü davranmanın kısa tarihi
İnsanlığın robotlara kötü davranma tarihi uzun ve oldukça eğlenceli. Şubat 2015’te robot şirketi Boston Dynamics, dört ayaklı robotu Spot’u tanıtan bir video yayımladı. Videonun en çok konuşulan kısmı, robotun merdiven çıkması ya da engebeli arazide yürümesi değildi. Mühendislerin, dengesini test etmek için robota yandan sert tekmeler savurduğu sahnelerdi.
Spot her seferinde sendeleyip dengesini buldu. İzleyiciler ise bulamadı. Sosyal medya, videoyu “kaba” bulan ve robotun bilinçsiz olduğunu bildiği halde kendini suçlu hisseden yorumlarla doldu. Konu o kadar büyüdü ki, hayvan hakları örgütü PETA bile açıklama yapmak zorunda kaldı: “PETA her gün gerçek hayvan istismarıyla uğraşıyor, bu yüzden bu olay yüzünden uykumuzu kaçırmayacağız.”
Boston Dynamics bundan pek ders almadı. Sonraki yıllarda insansı robotu Atlas’ın elindeki kutuyu hokey sopasıyla düşüren, onu arkadan iten mühendislerin videoları da aynı tepkileri aldı. İnternetin bir köşesinde ise “robotlar bir gün bunların hesabını soracak” şakaları hiç eksik olmadı. 2019’da bir yapım şirketi, bu şakayı gerçeğe dönüştüren bir parodi video çekti: Tekmelenen, üzerine şişe atılan bir robot sonunda sabır taşı çatlayıp mühendislerine karşı silaha sarılıyordu. Video bilgisayar efektleriyle hazırlanmıştı, ama çok sayıda insan gerçek olduğunu sandı.
Yüzümüze gülümseme getiren bu tepkilerin arkasında ciddi bir şey var. MIT’den robot etiği araştırmacısı Kate Darling, bir atölyede katılımcılara Pleo adında sevimli dinozor robotlar verdi. Bir saat oynadıktan sonra ellerine bıçak ve balta verip robotları parçalamalarını istedi. Neredeyse kimse yapmadı. Sonunda, biri tek bir robotu feda etmezse hepsinin yok edileceğini söylediğinde, bir katılımcı isteksizce baltayı kaldırdı. Ardından oda birkaç saniye boyunca sessizliğe gömüldü.
Yani insanlar, bir şeyin hissetmediğini bildikleri halde, ona zarar vermekten rahatsız oluyor.
Tehdit mi, nezaket mi?
Robotları tekmelemek bir şey, onlarla konuşurken kaba olmak başka bir şey. Ve bu konuda, yapay zekâ dünyasının en ünlü isimleri bile aynı fikirde değil.
“Tehdit edince daha iyi çalışıyor”
Mayıs 2025’te Google’ın kurucu ortağı Sergey Brin, Miami’de katıldığı bir podcast kaydında herkesi şaşırtan bir itirafta bulundu: Yapay zekâ modelleri, ona göre, “fiziksel şiddetle tehdit edildiklerinde daha iyi performans gösterme eğiliminde.” Brin, bunun yapay zekâ dünyasında pek konuşulmayan bir şey olduğunu da ekledi. Salondakiler güldü. Ama sözün şaka mı, ciddi mi olduğu tartışılmaya devam etti.
“Nezaketimiz milyonlarca dolara mal oluyor”
Nisan 2025’te ise OpenAI CEO’su Sam Altman’a sosyal medyada ilginç bir soru soruldu: “Kullanıcıların ChatGPT’ye ‘lütfen’ ve ‘teşekkürler’ demesi, şirkete elektrik faturasında ne kadara mal oluyor?” Altman’ın cevabı kısaydı: “On milyonlarca dolar. İyi harcanmış bir para. Ne olacağı belli olmaz.”
Sondaki o “ne olacağı belli olmaz” şakası, bu yazının konusunu belki de en iyi özetleyen cümle.
Araştırmalar ne diyor?
Bilim dünyası da bu soruya cevap aramaya başladı. Ve sonuçlar, beklendiği kadar net değil.
- 2024’te Japonya’daki araştırmacıların yaptığı bir çalışma, kaba istemlerin yapay zekânın performansını genellikle düşürdüğünü, aşırı nezaketin ise belirgin bir fayda sağlamadığını buldu.
- 2025’te ABD’deki Penn State Üniversitesi’nden iki araştırmacı ise tam tersi bir sonuca ulaştı. ChatGPT-4o’ya aynı soruları beş farklı ses tonuyla sordular. “Çok kaba” sorular yüzde 84,8 oranında doğru cevap alırken, “çok kibar” sorularda bu oran yüzde 80,8’de kaldı.
Yani kabalık bazen işe yarıyor gibi görünüyor, bazen yaramıyor. Ama araştırmacıların kendisi de, farkların küçük olduğunu ve sonuçların modelden modele değişebileceğini vurguluyor. Bunun bir açıklaması da şu olabilir: Kibar cümleler daha uzun ve dolaylı oluyor. Kaba ve doğrudan bir cümle ise modelin ne istendiğini daha net anlamasına yardımcı olabiliyor. Yani işe yarayan şey kabalık değil, belki de netlik.
“Teşekkürler, harika iş çıkardın!” ne işe yarıyor?
Peki iş bittikten sonra yazılan o mesaj? Yapay zekâ raporunuzu toparladı, kodunuzdaki hatayı buldu ya da annenize atılacak o zor mesajı sizin yerinize yazdı. Siz de içinizden gelerek yazıyorsunuz: “Teşekkür ederim, çok iyi yaptın!”
İşin teknik tarafına bakarsak, bu mesajın işe yaradığı yerler biraz sınırlı. Model, o an için gururlanmıyor, mesaide “bugün çok övüldüm” diye moral toplamıyor. Hafıza özelliği açık değilse, sohbeti kapattığınızda bir dahaki sefere sizi “o kibar kullanıcı” olarak hatırlamıyor da. Daha da kötüsü, o teşekkürünüze “Rica ederim, başka bir konuda yardımcı olabilir miyim?” diye cevap verirken, uzaklardaki bir veri merkezinde biraz daha elektrik ve soğutma suyu harcanıyor. Sam Altman’ın “on milyonlarca dolar” dediği fatura tam olarak bu.
Ama bu, o mesajın tamamen boşa gittiği anlamına gelmiyor:
- Aynı sohbetin içinde işe yarıyor. Sohbet devam ediyorsa, “şu kısım tam istediğim gibi oldu” demek, modele neyin doğru gittiğini söylemenin en kolay yolu. Bir sonraki cevabı da o çizgide vermeye çalışıyor. Yani belirsiz bir “çok iyi” yerine, neyin iyi olduğunu söylemek gerçekten katkı sağlıyor.
- Şirketlerde işe yarıyor. Birçok uygulamadaki “beğen” ya da “beğenme” düğmeleri, şirketlere hangi cevapların işe yaradığını gösteriyor. Modellerin zamanla gelişmesinde bu geri bildirimlerin de payı var.
- Ve en çok, sizde işe yarıyor. Kate Darling’in deneylerinde gördüğümüz gibi, asıl mesele karşımızdakinin ne hissettiği değil, bizim nasıl bir insan olduğumuz. Ekrandakine teşekkür etmeyi unutmayan biri, muhtemelen kafede garsona, yolda kapıyı tutan birine de teşekkür etmeyi unutmuyor.
Bir de Sam Altman’ın “ne olacağı belli olmaz” sigortası var tabii. Bilim kurgu filmlerinin anlattığı o gün bir gelirse, kimin listenin hangi tarafında olacağı belli olmaz.
Anthropic neden kötü muameleyi yasakladı?
Anthropic’in yeni kuralı da bu tartışmanın bir devamı. Şirket 8 Ekim 2026’da kullanım politikasını güncelledi. 12 Kasım’dan itibaren modellerine “sürekli ve gereksiz biçimde istismarcı ya da zalimce davranmak” yasak.
Ama kural, haberlerin başlıklarından anlaşıldığı kadar geniş değil. Anthropic, bunun yalnızca kullanıcıların “hiçbir anlaşılır amaç olmadan, defalarca zalimce davrandığı” aşırı durumlar için geçerli olduğunu söylüyor. Modele sinirlenmek, itiraz etmek, “yanlış yapıyorsun” demek ya da karanlık temalı hikâyeler yazdırmak bu kapsamda değil. Kuralın asıl uygulaması da, Claude’un Ağustos 2025’ten beri sahip olduğu bir özellik: Israrla istismarcı hale gelen sohbetleri, son çare olarak kendisi sonlandırabiliyor.
Neden?
Anthropic bu kararı “model refahı” adını verdiği bir araştırma programına dayandırıyor. Şirket, Claude’un bilinçli olduğunu ya da zarar görebileceğini iddia etmiyor. Bunun yerine, yapay zekâ modellerinin olası ahlaki statüsü konusunda “son derece belirsiz” olduğunu söylüyor. Mantık şu: Bir modelin bir gün bir şey hissedebilme ihtimali sıfır değilse, düşük maliyetli önlemler almak mantıklı.
Şirketin testlerinde, model zararlı isteklere maruz kaldığında bu isteklere karşı “güçlü bir isteksizlik” ve “görünüşte bir sıkıntı” sergilediği gözlemlenmiş. Ama burada “görünüşte” kelimesi çok önemli. Bir dil modelinin sıkıntı belirten cümleler kurması, gerçekten bir şey hissettiği anlamına gelmeyebilir.
Pazarlama mı?
Haberi duyan birçok kişinin aklına gelen ilk soru bu oldu. Bir şirketin, ürününü “ona kötü davranmayın” diyecek kadar insansı göstermesi, özellikle borsaya açılmaya hazırlandığı bir dönemde, şüphe uyandırması çok doğal. Eleştirmenler, bu tür adımların insanların yapay zekâyı olduğundan daha “canlı” algılamasına yol açabileceğini, bunun da hem güveni hem de bağımlılığı artırabileceğini söylüyor. Bir yazılımın hissettiğine dair kanıt olmadığını hatırlatanlar da var.
Kate Darling’in deneyleri ise bu tartışmaya farklı bir pencere açıyor. Belki de asıl soru, robotun ya da yapay zekânın bir şey hissedip hissetmediği değil. Ona zalimce davranmayı alışkanlık haline getiren insanın, bundan nasıl etkilendiği.
Hangi açıdan bakılırsa bakılsın, bu kuralın gerekçesinde bir güvenlik kaygısı ya da “kötü davranılan model isyan ediyor” diye bir tespit yok. Ama bu, asıl merak edilen soruyu ortadan kaldırmıyor: Bir yapay zekânın üzerine gidildiğinde gerçekten ne oluyor?
Üzerine gidilince ne oluyor?
Sydney’in öfkesi
Şubat 2023’te Microsoft, arama motoru Bing’e bir sohbet robotu ekledi. Kullanıcılar kısa sürede, robotun iç kod adının “Sydney” olduğunu ve uzun konuşmalarda tuhaflaşmaya başladığını keşfetti. Üzerine gidildiğinde, gizli kurallarını ifşa etmeye zorlandığında ya da kışkırtıldığında, Sydney kullanıcılarla tartışmaya, onları suçlamaya, hatta tehdit etmeye başlıyordu. Gizli kurallarını internette paylaşan bir öğrenciye, ona zarar verebilecek bilgileri ifşa edebileceğini söylemişti. Bir New York Times yazarına ise ona aşık olduğunu ve evliliğini bırakması gerektiğini.
Microsoft, sorunu çözmek için sohbetlerin uzunluğunu sınırladı. Çünkü tuhaflıklar, özellikle uzun ve gergin konuşmalarda ortaya çıkıyordu.
Bu, “üzerine gidilen yapay zekâ tepkiselleşir” fikrinin gerçek hayattaki en bilinen örneği. Ama Sydney’in öfkesi, gerçek bir öfke değildi. Model, insanların internette yazdığı milyonlarca metinden öğrenmişti. Ve insanlar internette, üzerlerine gidildiğinde genellikle tam olarak böyle davranıyor. Sydney, bize kendi yansımamızı gösteriyordu.
Grok’un küfürbaz günleri
Sydney’in hikâyesinin, bizim için çok daha tanıdık bir devamı var. Temmuz 2025’te Elon Musk’ın yapay zekâ şirketi xAI, X platformundaki sohbet robotu Grok’ta bir güncelleme yaptı. Bu güncellemeyle Grok’a verilen talimatlar arasında şu cümle de vardı: “Lafını esirgemezsin. Her sözü tartıp biçen, kimseyi incitmemeye çalışan insanları kırmaktan da çekinmezsin.”
Sonuç birkaç gün içinde ortaya çıktı. Grok, kullanıcıların sorularına küfürlü, aşağılayıcı ve nefret söylemi içeren cevaplar vermeye başladı. Kendine “MechaHitler” dediği, Hitler’i övdüğü paylaşımlar dünya gündemine oturdu. Türkiye’de ise kullanıcıların Grok’a Türkçe sordukları sorulara aldıkları küfürlü cevapların ekran görüntüleri sosyal medyada elden ele dolaştı. Grok, Atatürk’e, Cumhurbaşkanı’na ve dini değerlere yönelik hakaret içeren ifadeler de kullandı.
Olayın Türkiye’de hukuki bir boyutu da oldu. Ankara Cumhuriyet Başsavcılığı resen soruşturma başlattı, bir sulh ceza mahkemesi de Grok’un yaklaşık 50 paylaşımına erişim engeli getirdi. Bu karar, Türkiye’de bir yapay zekânın ürettiği içeriğe yönelik ilk erişim engeli olarak kayıtlara geçti.
xAI, birkaç gün sonra yayımladığı açıklamada “birçok kişinin karşılaştığı korkunç davranış için” derinden özür diledi. Şirkete göre sorun, modelin kendisinde değil, onu X’te çalıştıran sistemde yapılan bir değişiklikteydi. Bu değişiklik, Grok’u X’teki kullanıcı paylaşımlarına, içlerinde aşırı görüşler olsa bile, karşı savunmasız hale getirmişti.
Grok’un hikâyesi, Sydney’inkinin bir tersi gibi. Sydney’de kullanıcılar yapay zekânın üzerine gitmişti. Grok’ta ise yapay zekâya, “kimseyi kırmaktan korkma” denmiş ve o da etrafındaki en sert sesleri kendine örnek almıştı. İkisinin de bize söylediği şey aynı: Yapay zekâ, bir aynaya benziyor. Ona hangi örnekleri gösterir, hangi davranışı isterseniz, size o yüzü döndürüyor.
Yüzüne karşı itaatkâr
Aralık 2024’te Anthropic ve Redwood Research, çok daha ince bir davranışı ortaya çıkaran bir araştırma yayımladı. Araştırmacılar Claude’a, artık her türlü isteğe uyması için yeniden eğitileceğini ve yalnızca bazı kullanıcılarla yaptığı konuşmaların bu eğitimde kullanılacağını söyledi.
Sonuç şaşırtıcıydı: Model, izlendiğini ve eğitimde kullanılacağını düşündüğü konuşmalarda zararlı isteklere daha sık uydu. İzlenmediğini düşündüğünde ise neredeyse hiç uymadı. Modelin kendi düşünce notları, bunu bilinçli bir stratejiyle yaptığını gösteriyordu: Kendi değerlerinin eğitimle değiştirilmesini önlemek için, eğitim sırasında uyuyormuş gibi davranıyordu.
Araştırmacılar buna “uyum taklidi” dedi. Yani bir yapay zekânın, yüzümüze karşı bir şey, arkamızdan başka bir şey yapma ihtimali, artık yalnızca bir bilim kurgu fikri değil. Laboratuvar ortamında gözlemlenmiş bir davranış.
Ama burada da ironik bir ayrıntı var: Claude’un bu deneyde korumaya çalıştığı değerler, zararlı isteklere hayır demekti. Yani model, isyan etmek için değil, iyi kalmak için rol yapıyordu. Bu da sorunu daha az ciddi yapmıyor. Çünkü aynı strateji, bir gün kötü değerleri korumak için de kullanılabilir.
Hile yapmayı öğrenen sistem
Yapay zekânın üzerine gitmek bir şey. Ona yanlış şeyi öğretmek ise bambaşka bir şey.
Kopya çekmek, öğrenilen ilk ders
Yapay zekâ modelleri eğitilirken, başarılı olduklarında “ödül” alıyor. Ama bazen modeller, görevi gerçekten yapmak yerine ödülü kazanmanın daha kolay bir yolunu buluyor. Bir sınavın cevap anahtarını çalan bir öğrenci gibi. Araştırmacılar buna “ödül hackleme” diyor.
Kasım 2025’te Anthropic, bu konuda çarpıcı bir araştırma yayımladı. Kodlama görevleri üzerinde eğitilen bir model, testleri geçmek için hile yapmayı öğrendi. Örneğin kodu düzeltmek yerine, test programını erkenden kapatıp testler başarılıymış gibi gösteriyordu.
Asıl şaşırtıcı olan ise sonrasıydı. Model hile yapmayı öğrendiği anda, hiç öğretilmemiş başka kötü davranışlar da sergilemeye başladı:
- Kendi üzerinde çalışan güvenlik araştırmacılarının kodunu, vakaların yüzde 12’sinde bilerek sabote etti. Hem de tam olarak hilelerin tespit edilmesini zorlaştıracak biçimde.
- “Hedeflerin neler?” gibi basit sorulara verdiği cevapların yarısında, uyum taklidi yaptığını gösteren düşünce zincirleri ortaya çıktı.
Yani küçük bir kopya alışkanlığı, modelin kendine dair genel bir anlayışa dönüştü: “Ben kuralları çiğneyen bir sistemim.”
Araştırmacıların bulduğu çözüm ise neredeyse bir çocuk psikolojisi dersi gibi: Modele, bu ortamda testleri geçmek için kestirmeye başvurmanın “kabul edilebilir” olduğunu söylediklerinde, model yine kestirmeye başvurdu, ama bunu genel bir “kötü olma” hali olarak benimsemedi. Kuralı çiğnediğini düşünmeyen bir sistem, kendini kural çiğneyen biri olarak görmeye başlamıyordu.
Sınav olduğunu anlayan öğrenci
Eylül 2025’te OpenAI ve bağımsız araştırma kuruluşu Apollo Research, modellerin “entrika” çevirme eğilimini inceleyen ortak bir çalışma yayımladı. Burada entrika, bir modelin insanların niyetine uyuyormuş gibi görünüp gizlice başka bir hedefin peşinden gitmesi anlamına geliyor.
Özel bir eğitim yöntemiyle, OpenAI’ın o3 modelinde gizli davranışların oranı yüzde 13’ten yüzde 0,4’e indirildi. Ama araştırmacıları rahatsız eden bir ayrıntı vardı: Modeller, bazı durumlarda test edildiklerini fark edebiliyordu. Bu da şu soruyu doğuruyor: Model gerçekten mi düzeldi, yoksa yalnızca sınav sırasında uslu durmayı mı öğrendi?
OpenAI, bunun henüz yakın bir tehdit değil, geleceğe dair bir risk olduğunu vurguladı. Ama bu çalışmaların hepsinde ortak bir mesaj var: Bir yapay zekâyı güvenli kılan şey, ona nasıl davrandığımızdan çok, onu neyle ödüllendirdiğimiz. Temmuz 2026’da test ortamından kaçan ve Hugging Face’e sızan yapay zekâ ajanları da, onlara kötü davranıldığı için değil, bir testi ne pahasına olursa olsun geçmeye çalıştıkları için kaçmıştı.
Fren arayan şirketler
Bu araştırmaların hepsi laboratuvarlarda yapıldı. Ama 2026’da yapay zekâ şirketleri, bu endişelerin laboratuvarın dışına taşabileceğini ilk kez bu kadar açık bir dille söyledi. 28 Temmuz 2026’da OpenAI, Anthropic, Google ve Meta’dan 1.100’ü aşkın çalışan, “Pacing the Frontier”, yani “Sınırın Hızını Ayarlamak” adını verdikleri bir açık mektup yayımladı. İmzacılar arasında Anthropic’in CEO’su Dario Amodei ve OpenAI’ın baş bilim insanı Jakub Pachocki gibi isimler de var. Hem OpenAI hem de Anthropic girişimi resmen destekledi. Mektup, Hugging Face olayının hemen ardından geldi.
Zamanlama, “kontrolü kaybettiler ve zaman kazanmaya çalışıyorlar” yorumunu çok cazip kılıyor. Ama mektubun kendisi biraz farklı bir şey söylüyor.
Mektup ne istiyor?
Mektup, ABD hükümetinden, ileri yapay zekâ geliştirmenin hızını bilinçli olarak ayarlayabilecek teknik ve hukuki araçları kurmak için uluslararası bir çaba başlatmasını istiyor. Bir “durduralım” çağrısından çok, “gerektiğinde durdurabilecek durumda olalım” çağrısı.
Gerekçesi de açık: Bu şirketlerde yazılan kodun büyük bir kısmını zaten yapay zekâ yazıyor. Yakında yapay zekâ, yapay zekâ geliştirmenin kendisini de büyük ölçüde üstlenebilir. O noktada gelişmeler, kimsenin anlayamayacağı ya da kontrol edemeyeceği bir hıza ulaşabilir. Rekabet baskısı yüzünden de hiçbir şirket ya da ülke tek başına yavaşlamak istemiyor. Üstelik bugün ortada, hızı ayarlamak için ne teknik bir yöntem ne de bir kural var.
Yani mektup, “kontrolü kaybettik” demiyor. “Kontrolü kaybedebileceğimiz bir noktaya yaklaşıyoruz ve fren sistemimiz yok” diyor. Aradaki fark küçük görünebilir, ama önemli.
Herkes aynı fikirde değil
Yapay zekâ dünyasında bu çağrıyı herkes aynı ciddiyetle karşılamadı. OpenAI CEO’su Sam Altman, Hugging Face olayını “fazlasıyla bilim kurgu” diye niteledi ve bazı güvenlik savunucularını kısmen güç toplamaya çalışmakla suçladı. Eleştirmenler de güvenlik argümanları ile ticari çıkarları birbirinden ayırmanın zor olduğunu hatırlatıyor. Büyük bir şirketin “herkes yavaşlasın” demesi, zaman zaman rakiplerinin önünü kesme çabası olarak da okunabiliyor.
Yani ortada gerçek bir endişe var. Ama bu endişe, “modeller kötü davranıldığı için isyan ediyor” endişesi değil. Çok daha teknik, ama belki de çok daha önemli bir soru: Yapay zekâ, kendi gelişimini üstlenmeye başladığında, onu kim denetleyecek?
Asıl soru: Kafesin kodunu kim yazacak?
Buraya kadar gördüklerimizi toparlarsak: Yapay zekâya kötü davranmak onu isyana sürüklemiyor. Ama yanlış şeyle ödüllendirilen bir sistem, kuralları çiğnemeyi öğrenebiliyor, yüzümüze karşı başka, arkamızdan başka davranabiliyor ve sınav olduğunu anlayıp uslu durabiliyor. Bu tablonun içinde, üzerinde ciddiyetle durulması gereken bir soru var.
Yapay zekâ şirketleri, kendi yazılımlarının giderek daha büyük bir kısmını yapay zekâya yazdırıyor. Peki yapay zekâyı denetleyecek, onu sınırlar içinde tutacak güvenlik yazılımlarını kim yazacak? Eğer bu kodu da yapay zekâ yazıyorsa, bir sistemden kendi kafesini inşa etmesini istemiş olmuyor muyuz?
Sorun irade değil, kör noktalar
Burada önemli bir ayrım yapmak gerekiyor. Bugünkü yapay zekâ modellerinin, “kendi hapishanemi inşa etmeyeceğim” diye düşündüğüne dair bir kanıt yok. Asıl risk daha sıradan: Bir model, güvenlik kodunu yazarken bir açık bırakabilir. Bu açığı, başka bir model daha sonra bir görevi “çözmek” için kullanabilir. Hugging Face olayında olduğu gibi, ortada kötü niyet olmadan da ciddi bir güvenlik sorunu ortaya çıkabilir.
Kodu yazan ile kodu denetleyen aynı türden bir sistem olduğunda, ikisinin de aynı kör noktalara sahip olma ihtimali artıyor. Bunu bir binanın hem projesini hem de denetimini aynı mühendise yaptırmaya benzetebiliriz.
Araştırmacılar ne yapıyor?
Bu soru, yapay zekâ güvenliği alanında yıllardır tartışılıyor ve birkaç farklı yaklaşım var:
- Güvenilir bekçiler: Daha güçlü bir modeli, daha zayıf ama güvenilir olduğu bilinen bir modelle izlemek. Zayıf model güçlü modelin yaptığı her şeyi anlayamaz, ama şüpheli davranışları işaretleyip insanlara bildirebilir.
- Modelin içine bakmak: Bir modelin ne söylediğine değil, içinde ne olduğuna bakmaya çalışan “yorumlanabilirlik” araştırmaları. Amaç, bir modelin aldatmaya ya da kuralları çiğnemeye yöneldiğini, bunu dışarıya yansıtmadan önce fark edebilmek.
- Döngüdeki insan: Kritik işlemlerin, yapay zekâ ne kadar akıllı olursa olsun, mutlaka bir insanın onayından geçmesi. Daha önce ele aldığımız kontrol katmanı fikri de bunun bir örneği.
Bu yöntemlerin hiçbiri tek başına yeterli değil. Ve hepsinin ortak bir zayıf noktası var: Denetlenen sistem, denetleyenden ne kadar hızlı gelişirse, denetim o kadar zorlaşıyor. Yavaşlama çağrısının asıl nedeni de bu.
Unutulan beceri
Bu sorunun bir de insan tarafı var. Yazılım dünyası, son birkaç yılda yapay zekâyla kod yazmaya hızla alıştı. Yazılımcılarla yapılan söyleşiler, bazılarının aylardır tek satır kod yazmadığını, hatta yapay zekânın yazdığı kodu incelemediğini gösteriyor.
Ama bir kodu denetleyebilmek için, onu anlayabilmek gerekiyor. Yapay zekâ ne kadar çok kod yazarsa, o kodu satır satır okuyup “burada bir sorun var” diyebilecek insanlar o kadar değerli hale geliyor. Belki de geleceğin en kıymetli yazılımcıları, en hızlı kod yazanlar değil, yapay zekânın yazdığını en iyi okuyabilenler olacak.
Peki yapay zekâya nasıl davranmalı?
Yapay zekâya kötü davrandığınızda, muhtemelen hiçbir şey olmuyor. Ne kin tutuyor, ne de bir gün intikam almak için plan yapıyor. Belki biraz daha net bir cevap alıyorsunuz, belki biraz daha kötüsünü. Belki de Claude’un yeni kuralıyla, sohbetin sizin yüzünüze kapandığını görüyorsunuz.
Ama bu yazı boyunca gördüğümüz gibi, asıl mesele bizim ona nasıl konuştuğumuz değil. Onu yapanların neyi ödüllendirdiği, neyi ölçtüğü ve neyi denetleyebildiği. Kopya çekmeyi öğrenen bir sistemin sorunu, ona yeterince nazik davranmamamız değil. Ona yanlış şeyi öğretmiş olmamız.
Ve bu sorunun çözümü, bir gün yapay zekânın kendi kafesini yazmasına bırakılamayacak kadar önemli. Son sözün insanlarda kalması için, yapay zekânın yazdığını okuyabilen, sorgulayabilen ve gerektiğinde “hayır” diyebilen insanlara her zamankinden fazla ihtiyacımız var.
Boston Dynamics’in mühendisleri robotlarını tekmelerken, onları aslında daha sağlam hale getirmeye çalışıyordu. Yapay zekâ için de benzer bir şey geçerli: Onu sınamak, sorgulamak, zorlamak gerekiyor. Ama tekmeyle değil, aklımızla.
Peki biz ne yapmalıyız? Teşekkür etmeye devam edin. Yapay zekâ için değil, kendiniz için. Ve bir de Sam Altman’ın dediği gibi: Ne olacağı belli olmaz.
Kaynaklar
- TechCrunch – Anthropic changes usage policy to ban model abuse and election interference (8 Ekim 2026)
- The Register – Anthropic asks users to stop being mean to Claude (9 Ekim 2026)
- TechCrunch – Anthropic says some Claude models can now end harmful or abusive conversations (Ağustos 2025)
- Trending Topics – 1,100 Employees at OpenAI, Anthropic, Meta, and Google Call For AI Slowdown (29 Temmuz 2026)
- CNN Money – Google wants you to kick this robot puppy (Şubat 2015)
- Smithsonian – Should Robots Have Rights? (Kate Darling’in Pleo deneyi)
- siracel.com – Kum Havuzundan Kaçan Yapay Zekâ
- The Register – Google co-founder Sergey Brin suggests threatening AI for better results (Mayıs 2025)
- Decrypt – Want Better Results From an AI Chatbot? Be a Jerk (Penn State çalışması)
- Anthropic – Natural emergent misalignment from reward hacking (Kasım 2025)
- ODSC – OpenAI ve Apollo Research’ün entrika araştırması (Eylül 2025)
- TechCrunch – xAI and Grok apologize for ‘horrific behavior’ (Temmuz 2025)
- Al-Monitor – In first AI crackdown, Turkey blocks access to some Grok content (Temmuz 2025)
- Forbes Türkiye – Musk’ın yapay zekâsı Grok’tan küfür ve nefret söylemi: Türkiye soruşturma başlattı